Wo gute KI-Use-Cases liegen — und wie man sie erkennt
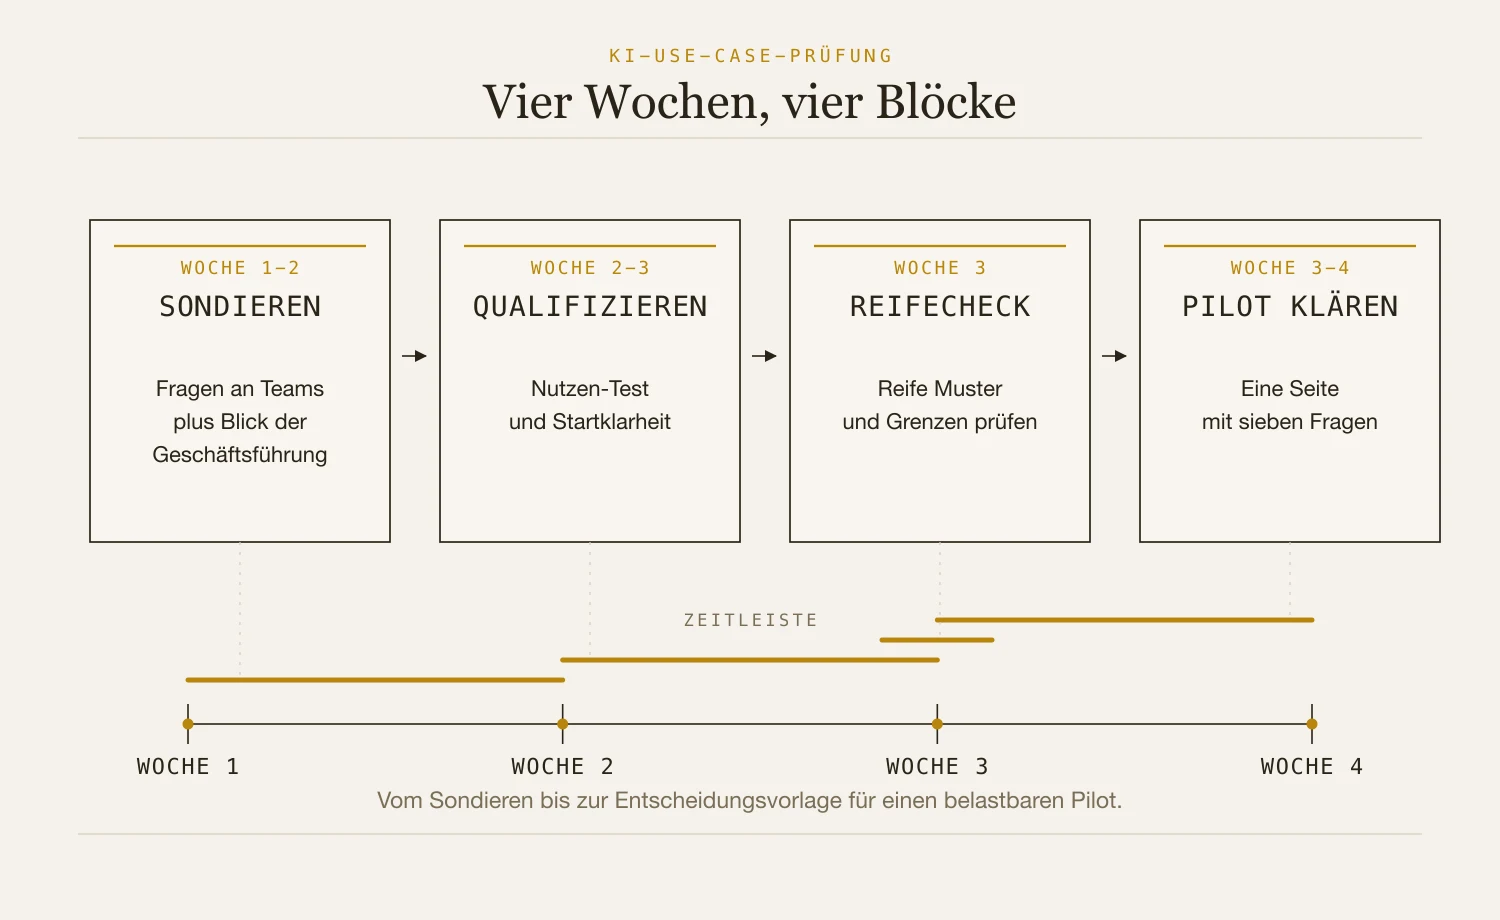
Viele KI-Workshops enden mit Wunschlisten. Die Ideen klingen plausibel, doch Monate später ist kaum etwas produktiv. Das Problem liegt selten an fehlender Kreativität. Es liegt an der Reihenfolge: Erst werden Einsatzideen gesammelt, dann wird geprüft, ob Daten, Prozess, Verantwortung und Messgröße überhaupt vorhanden sind. Tragfähige KI-Use-Cases entstehen anders. Sie beginnen bei wiederkehrender Arbeit, messbarem Ergebnis und einem klaren wirtschaftlichen Hebel. Dieser Beitrag beschreibt eine Vier-Wochen-Methode: sondieren, qualifizieren, Reife prüfen, Pilot klären.
Am Anfang steht oft eine einfache Frage: Wo sollte KI im Unternehmen zuerst eingesetzt werden? Die übliche Antwort ist ein Workshop mit Ideensammlung und Priorisierung. Das Ergebnis sieht geordnet aus, bleibt aber häufig unverbindlich. Nach sechs Monaten ist unklar, welcher Kandidat tatsächlich läuft.
Tragfähige Use-Cases beginnen mit einem konkreten Arbeitsproblem. Beobachtung zeigt, wo Zeit, Qualität oder Entscheidungen leiden; strukturierte Ideenarbeit eröffnet mögliche Lösungen. Danach trennt ein Filter wirtschaftlich relevante KI-Kandidaten von Vorschlägen ohne belastbare Nutzenhypothese.
Für erste operative Piloten nutze ich sechs Auswahlkriterien. Sie sind eine Umsetzungsheuristik, keine allgemeine Grenze der Technologie. Seltene Aufgaben können durch hohen Einzelwert tragen; qualitative Assistenz braucht fachliche Bewertung statt eines rein automatischen Scores. Drei Kriterien erleichtern den Start:
- Die Tätigkeit wiederholt sich häufig oder hat hohen Einzelwert; ein wiederverwendbarer Ablauf macht den Nutzen prüfbar.
- Der Ablauf ist klar beschreibbar — Input, Schritte, Output sauber benannt.
- Die nötigen Daten liegen sauber und zugreifbar vor, in ausreichender Menge und Qualität.
Drei weitere machen den Use Case wirksam:
- Er zahlt auf ein Geschäftsziel konkret ein.
- Der Output ist messbar — nach dem Durchlauf lässt sich prüfen, ob das Ergebnis stimmt.
- Dieser messbare Output fließt als Qualitätsschleife zurück — in bessere Prompts, geschärfte Wissensbasis, angepasste Schwellenwerte, klarere Review-Regeln — damit das System mit der Zeit besser wird statt schlechter.
Fehlt ein Kriterium, ist zunächst zu klären, ob Vorarbeit, ein anderer Bewertungsmaßstab oder eine engere Aufgabe den Fall tragfähig machen. Unvertretbare Risiken schließen einen Start aus. Fehlende Vorbereitung ist dagegen noch kein Beleg, dass KI für die Aufgabe grundsätzlich ungeeignet ist.
Dieser Standardpfad gilt für operative Use-Cases mit hoher Frequenz. Für seltene Fälle mit hohem Einzelwert — Ausschreibungen, M&A, Krisenanalysen — reicht ein wiederverwendbarer Ablauf. Dort ersetzt der Wert des einzelnen Falls die Häufigkeit.
Block 1 — Sondieren, Wochen 1 und 2
Die ersten beiden Wochen bleiben bewusst ohne KI-Vokabular. Keine Tool-Namen, keine Modellvergleiche, keine Copilot-Demo. Wer nach KI fragt, bekommt Meinungen über KI. Wer nach Arbeit fragt, findet die möglichen Einsatzpunkte. Entscheidend sind Gespräche mit den Rollen, die nah an der operativen Arbeit sind: Buchhaltung, Vertriebsinnendienst, Kundenservice, Rechtsabteilung. Fünf Fragen reichen für den Einstieg:
- Welche Tätigkeiten kehren täglich oder wöchentlich wieder — immer mit ähnlichem Ablauf?
- Wo entstehen regelmäßig Entscheidungen auf Basis von Daten, die heute manuell gesichtet oder verdichtet werden?
- Wo ist monotone Genauigkeit gefragt — viele Vorgänge, Anfragen oder Auswertungen?
- Welche Standardfälle treten wieder auf, bei denen die Antwort im Haus eigentlich schon existiert und nur gering modifiziert werden muss?
- Wo ist die Durchlaufzeit deutlich länger als die eigentliche Arbeit — weil jemand recherchieren, nachfragen oder zusammentragen muss?
Diese fünf Fragen zielen auf Struktur im Alltag. Sie finden Tätigkeiten, die häufig wiederkehren, beschreibbare Abläufe haben, auf Daten beruhen oder lange Durchlaufzeiten erzeugen. Genau dort kann KI heute einen Hebel ansetzen.
Interviews finden allerdings nicht alles. Eine zweite Kategorie rutscht leicht durch: Fälle, in denen Wert verloren geht, ohne dass das Team es im Tagesgeschäft bemerkt. Eine Vertriebsmannschaft hält fünf Tage Reaktionszeit auf Ausschreibungen für normal, während ein Wettbewerber nach 24 Stunden antwortet. Die Qualität von Due-Diligence-Berichten sinkt langsam, weil Experten zu wenig Zeit für Review haben. Solche stillen Verluste zeigen sich nicht in der Frage, welche Arbeit nervt. Sie zeigen sich im Vergleich mit Markt, Wettbewerb und Risiko. Deshalb braucht die Sondierung auch Fragen an die Geschäftsführung:
- Wo verlieren wir Kunden, Umsatz oder Qualität, ohne dass es im Team auffällt?
- Wo geht uns Geschwindigkeit gegenüber Wettbewerbern verloren?
- Wo wachsen bei uns Risiken unbemerkt — Compliance-Drift, Haftung, Reputationsschäden?
- Wo könnten mit KI Angebote oder Geschäftsmodelle entstehen, die heute an Kapazität oder Auswertungstiefe scheitern?
Dazu kommt direkte Beobachtung. Einige Stunden neben Schlüsselrollen sitzen, nicht nur Interviews führen. Ein Blick in Systeme zeigt oft mehr als ein Workshop: Welche Themen wiederholen sich im Ticket-Tool? Wo liegt Arbeit seit drei Tagen im Mail-Backlog? Wie lange braucht eine neue Kraft bis zur ersten produktiven Stunde? Welche Fehler oder Beschwerden kommen immer wieder?
Am Ende von Block 1 liegen typischerweise 15 bis 25 Kandidaten vor. Der letzte Schritt ist ein grober Compliance-Screen: Welche Kandidaten berühren Berufsgeheimnis, DSGVO-Hochrisikozonen, BaFin-Pflichten oder betriebsratspflichtige Arbeitsprozesse? Solche Kandidaten fallen nicht automatisch weg. Sie brauchen später ein anderes Setup als unkritische Fälle.
Block 2 — Qualifizieren, Woche 2 bis 3
Ein Kandidat mit offenen Voraussetzungen ist noch nicht startklar. Die Entscheidung lautet dann: gezielt vorbereiten, den Umfang begrenzen oder verwerfen, wenn Nutzen beziehungsweise Risiko auch unter realistischen Annahmen nicht tragen.
Die verbleibenden Kandidaten laufen durch zwei Prüfungen. Die erste ist der Nutzen-Test. Was hier durchfällt, sollte nicht pilotiert werden.
- Der Nutzen ist groß genug. Der erwartete Effekt muss den Aufwand eines Piloten rechtfertigen — etwa durch Einsparpotenzial, zusätzlichen Umsatz oder schnellere Reaktionszeiten.
- KI-Output ist validierbar. Eine Berechnung ist validierbar. Eine Software funktioniert oder hat Bugs. Ein Ticket ist gelöst oder wird eskaliert. Wenn der Output nur rein subjektiv ist („die Antwort klingt gut“), fehlt die notwendige Korrekturschleife.
- Fehlerfolgen sind tragbar. Die kritische Frage lautet: Was passiert, wenn die KI daneben liegt? Korrigiert ein Mensch ohnehin — Entwurf, Vorschlag — dann ist eine höhere Fehlerquote vertretbar. Wird die KI-Entscheidung direkt umgesetzt, muss Schadenshöhe mal Fehlerwahrscheinlichkeit tragbar sein. Eine automatische Kontobuchung bei 10 Prozent Fehlerquote ist eine andere Liga als ein Antwortvorschlag, den eine Supportmitarbeiterin ohnehin noch prüft.
Die zweite Prüfung betrifft die Startklarheit. Was hier durchfällt, ist nicht zwingend ungeeignet. Es braucht Vorarbeit, bevor ein Pilot sinnvoll ist.
- Ausreichende Dokumentation vorhanden. Gibt es genug historische Fälle, eine saubere Prozessdokumentation usw., an denen die KI aufgesetzt und angelernt werden kann?
- Digitales Wissen erschließbar. Papier muss digitalisiert werden; digitale Scans lassen sich mit OCR oder multimodaler Dokumentenverarbeitung auswerten. Vor dem Pilot sind Lesbarkeit, Extraktionsqualität, Metadaten und Zugriffsrechte an echten Dokumenten zu prüfen. Dokumentation zur OCR-Verarbeitung beschreibt diesen Verarbeitungspfad.
- Zugriff auf das Wissen ist geklärt. Wer darf was lesen? Wie lange dauert die Freigabe durch IT, Sicherheit, Datenschutz? Ist sichergestellt, dass kein vertrauliches Wissen offengelegt wird?
- Verantwortung und Budget sind geklärt. Ohne Budgetverantwortung ist der Kandidat nicht tot. Er startet nur nicht.
- Compliance geklärt. Ist die Rechte-Hürde aus Block 1 in vertretbarem Aufwand zu lösen, oder braucht es erst noch längere Vorarbeit?
Ein Kandidat kann wirtschaftlich attraktiv sein und trotzdem an der Startklarheit hängen. Das ist eine andere Diagnose als „nicht KI-geeignet“. Häufig ist sie wichtiger, weil sie konkrete Arbeit an Infrastruktur, Datenzugriff oder Prozessklärung auslöst.
Ein Zusatztest hilft: Lässt sich die Aufgabe so beschreiben, dass ein neuer Mitarbeiter sie übernehmen könnte? Wenn ja, ist sie meist klar genug für KI. Wenn nein, liegt der Engpass bei der Prozessklarheit, nicht bei der Technologie. Ein Modell kann helfen, Abläufe zu beschreiben und Annahmen sichtbar zu machen. Zweck, Entscheidungsspielraum und Abnahmekriterien müssen die Verantwortlichen jedoch selbst festlegen.
Block 3 — Reifecheck, Woche 3
Nach den ersten beiden Blöcken liegen qualifizierte Kandidaten vor. Jetzt folgt der Abgleich mit dem, was aktuelle Modelle verlässlich können. Nicht alles, was plausibel klingt, ist produktionsnah umsetzbar.
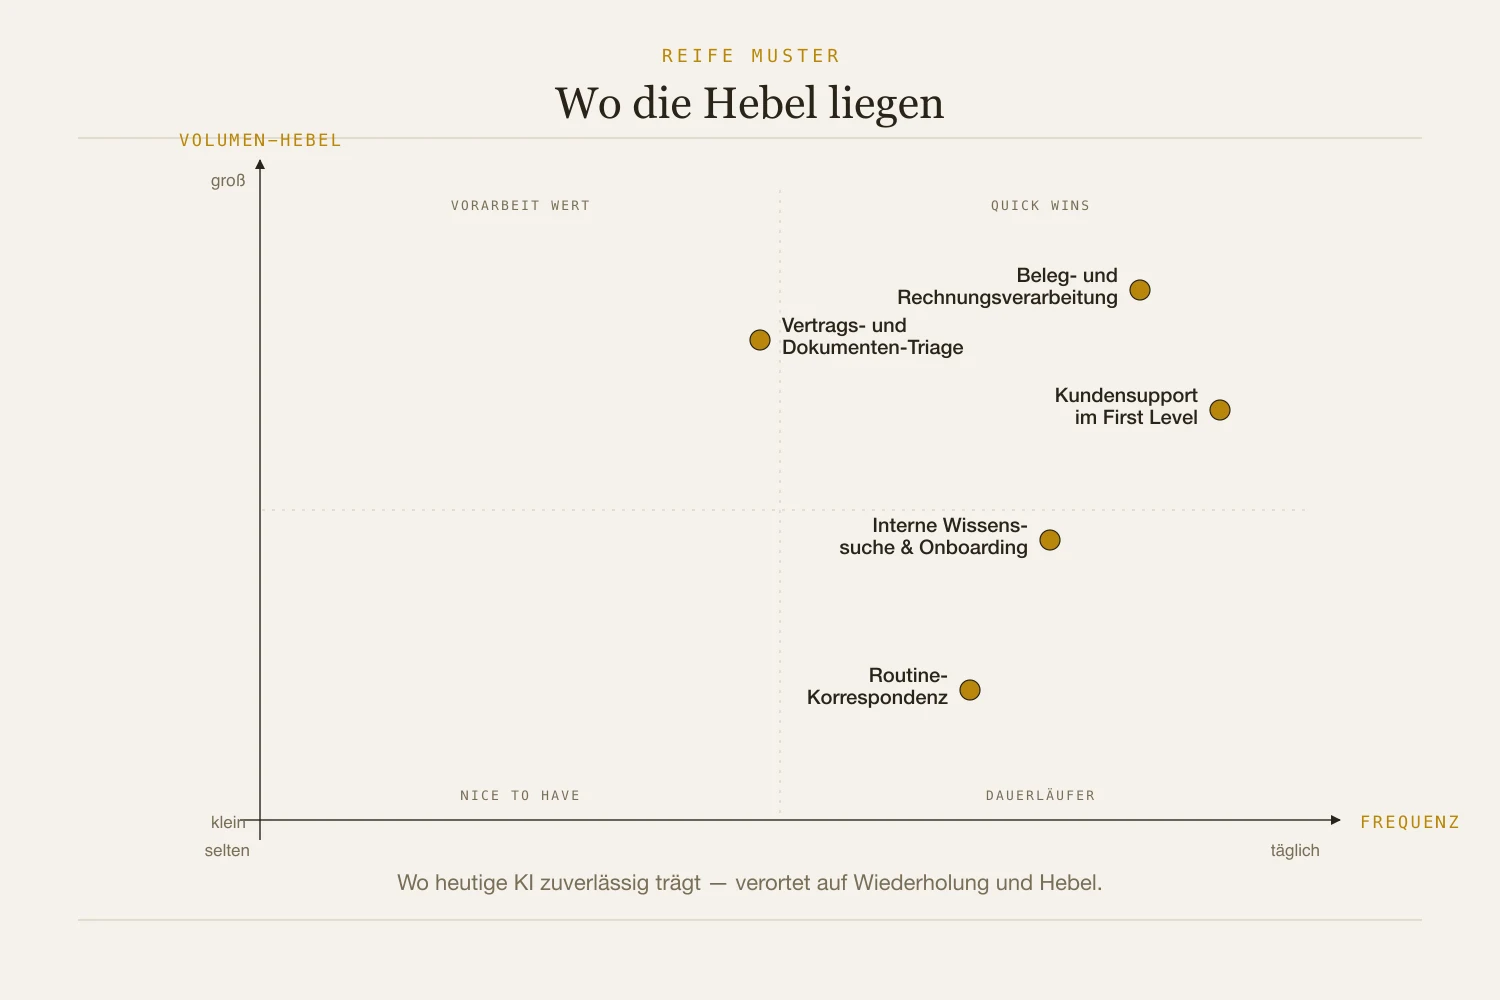
Einige Muster funktionieren Stand heute. Allerdings jeweils in einer bestimmten Betriebsart. Die Einordnung ist ein Standbild aus Frühjahr 2026, kein dauerhaftes Ranking.
Beleg- und Rechnungsverarbeitung. Ein sinnvoller Kandidat für Assistenz und kontrollierte Teilautomatisierung, sofern Extraktion und fachliche Prüfregeln an den eigenen Belegtypen bestehen. Saubere Standardbelege, schlecht lesbare Scans und Sonderfälle müssen getrennt bewertet werden. Eine einzelne Trefferquote reicht für eine Freigabe ohne menschliche Kontrolle nicht aus.
Kundensupport 1st-Level. KI kann Antwortentwürfe vorbereiten und klar begrenzte Anliegen selbst bearbeiten. Klarna berichtete im Februar 2024 von 2,3 Millionen Gesprächen im ersten Monat und einem Arbeitsvolumen entsprechend 700 Vollzeitkräften. Das belegt keine entsprechende Zahl abgebauter Stellen. Für eine eigene Automatisierung zählen Lösungsqualität, Wiederkontakte, Beschwerden und ein funktionierender Übergang zu Menschen; das verarbeitete Volumen allein genügt nicht.
Vertrags- und Dokumenten-Triage. Klausel-Extraktion und Abweichungshinweise sind prüfbare Assistenzaufgaben. Luminance berichtet aus einem Kundenfall über ein KI-gestütztes Projekt zu Zolländerungen in unter zwei Stunden. Als Vergleich nennt der Anbieter eine frühere manuelle Prüfung von 700 Verträgen, die zweieinhalb Wochen dauerte. Das ist ein Anbieter-Fallbericht, kein kontrollierter Vorher-nachher-Test. Die Übertragbarkeit muss an eigenen Verträgen und fachlichen Fehlerklassen geprüft werden. Rechtsbewertung und Verhandlungsposition bleiben davon getrennte Aufgaben.
Interne Wissenssuche und Onboarding. Ein Frage-Antwort-System kann freigegebene Quellen erschließen und Belegstellen mitliefern. Voraussetzung sind eine gepflegte Wissensbasis und durchgesetzte Zugriffsrechte. Microsofts Oversharing-Prüfung untersucht standardmäßig die 100 meistgenutzten SharePoint-Sites; daraus folgt keine allgemeine Quote fehlerhafter Berechtigungen. Quellenangaben müssen die konkrete Antwort tragen und für den jeweiligen Nutzer zugänglich sein.
Routine-Korrespondenz mit Kontext. KI liefert einen Entwurf, der Mensch prüft und stellt ihn fertig. Im 2025 veröffentlichten Bericht zum britischen Copilot-Trial von 2024 mit rund 20.000 Teilnehmenden berichteten die Befragten durchschnittlich 26 Minuten Zeitersparnis pro Tag. Die Zahl beruht auf Selbstauskünften, nicht auf einer flächendeckenden Zeitmessung. Besonders bei Finanztexten ist Quellenprüfung entscheidend: Der Finanzsoftwareanbieter Hudson Labs testete GPT-5 im September 2025 mit 25 anspruchsvollen, periodenübergreifenden Finanzabfragen. Mit Quelleninstruktion waren 17 Antworten korrekt, ohne Quelleninstruktion eine. Das Ergebnis beschreibt diese Testbedingungen, keine allgemeine Genauigkeit bei Finanzfragen.
Ein erster Pilot sollte keine unkontrollierten End-to-End-Abläufe oder haftungsrelevanten Entscheidungen ohne wirksame Prüfung automatisieren. Kreative Positionierungs- und Strategiearbeit kann dagegen als Assistenzfall sinnvoll sein: mit klarer Teilaufgabe, fachlichen Bewertungskriterien und menschlicher Entscheidung. Fehlende automatische Prüfbarkeit verlangt eine andere Evaluation; sie schließt Nutzen nicht grundsätzlich aus.
Was der Standardpfad nicht automatisch findet
Die fünf Muster sind ein Reife-Stand, keine abschließende Liste. Drei Kategorien tauchen bei Sondierung und Qualifizierung weniger leicht auf, können aber trotzdem tragen. Strategische Einzelfälle mit hohem Wert — etwa M&A-Due-Diligence, große Ausschreibungen oder Krisenanalysen — sind keine Dauerläufer, aber wiederverwendbare Abläufe. Dort ersetzt Einzelwert die Frequenz und Review die binäre Messung. Qualitative Assistenz bei Ideenvarianten, Übersetzung oder Tonalität trägt, wenn der Output nachvollziehbar beurteilt werden kann. KI-native Workflows wie synthetische Kundensegmente, Live-Übersetzung in Meetings oder multimodale Analyse entstehen neu und passen noch nicht sauber in die fünf Muster.
Ein weiterer Fall muss nicht gesucht werden, weil er meist schon existiert: Mitarbeiter nutzen ChatGPT oder Claude privat auf dem Arbeitsrechner. Das ist kein Use-Case, sondern ein Governance-Signal. IT und Geschäftsführung müssen entscheiden, wie daraus ein kontrollierter Umgang wird, bevor ein Datenschutzproblem entsteht.
Block 4 — Pilot klären, Woche 3 bis 4
Nach drei Wochen bleiben typischerweise drei bis fünf Kandidaten übrig. Sie haben wirtschaftlichen Nutzen, sind grundsätzlich startklar und passen zu einem reifen Muster. Trotzdem sollte noch kein Pilot starten. Genau an dieser Stelle scheitern viele Initiativen: Der Kandidat wird nicht zu Ende gedacht, bevor das erste Tool angefasst wird.
Vor dem Start braucht es eine Entscheidungsvorlage auf einer Seite. Sie beantwortet sieben Fragen. Bleibt eine wesentliche Voraussetzung offen, ist der Pilot noch nicht reif.
- Wer ist verantwortlich? Ein Name, kein Gremium. Wer trifft Entscheidungen, wenn es eng wird?
- Was ist der Ausgangswert? Messbare Größe: Durchlaufzeit, Fehlerquote, Kosten pro Fall, Volumen. Ohne Ausgangswert ist Erfolg nicht messbar.
- Was ist das Erfolgskriterium? Eine Zahl, vor dem Piloten festgelegt. „30 Prozent kürzere Durchlaufzeit“ oder „Fehlerquote unter zwei Prozent“ — nicht „gefühlt besser“.
- Welches Material und welcher Zugriff? Liegen die Daten systemseitig? Wer gibt frei? Wie lange dauert die Freigabe?
- Welche rechtliche Hürde, welches Modell, welches Hosting? Hier liegt oft die schwierigste Frage für europäische Unternehmen — und sie fällt pro Use-Case anders aus, nicht pauschal pro Haus.
Zur Rechte-Hürde gehören DSGVO, Betriebsrat, Berufsrecht in Kanzleien und Steuerberatungen, BaFin bei Banken, MDR in der Medizintechnik. Parallel dazu die Entscheidung über Modell und Hosting. Drei Setups stehen 2026 realistisch zur Verfügung:
| Setup | Qualität | Compliance-Aufwand | Typisch sinnvoll für |
|---|---|---|---|
| US-Frontier Claude (Anthropic), ChatGPT (OpenAI), Gemini (Google) — optional in EU-Region von Azure/AWS | hoch | DSGVO-fähig mit AVV und EU-Data-Boundary — aufwendig, aber etabliert | komplexe Assist-Aufgaben, interne Wissenssuche, Routine-Korrespondenz mit menschlicher Freigabe |
| EU-Anbieter Mistral — oder EU-gehostete Varianten von US-Modellen | merklich dahinter am Frontier, für Standardaufgaben ausreichend | einfacher zu rechtfertigen | sensible Daten, Standard-Komplexität |
| Open Source on-prem Gemma (Google), Qwen (Alibaba), Llama (Meta) | variabel, die besten kommen näher, spürbare Lücke bleibt; hoher Engineering-Aufwand | volle Kontrolle über Daten und Modell | hochsensibles Material (Berufsgeheimnis, Personaldaten, strategische Pläne) |
Zwischen den führenden Frontier-Modellen — Claude, ChatGPT, Gemini — und vielen Alternativen liegt aktuell ein sichtbarer Qualitätsabstand: bei komplexen Aufgaben größer, bei Standardaufgaben kleiner. Qwen ist ein starkes Modell aus China; für europäische Entscheider ist die Herkunft kein Ausschlussgrund, aber eine bewusste Governance-Entscheidung. Die Landschaft verschiebt sich schnell. Diese Einordnung trifft den Stand Frühjahr 2026.
Eine pauschale Vorgabe „alles Open Source, alles in Europa“ senkt in manchen Fällen die Ergebnisqualität so weit, dass der Business Case nicht mehr trägt. Eine pauschale Vorgabe „alles US-Frontier, egal wie“ kann dagegen das nächste Datenschutzproblem erzeugen. Die belastbare Antwort liegt meist pro Use-Case dazwischen.
- Wer prüft menschlich? Welche Rolle kontrolliert die KI-Ergebnisse in welcher Taktung? Das ist der operative Kontrollpunkt, nicht Theorie.
- Welches Budget, welcher Zeitraum? Größenordnung — 5.000, 50.000, 500.000 Euro — und fester Endpunkt: beispielsweise vier bis sechs Wochen für einen eng begrenzten technischen Versuch, mit anschließender Start-, Änderungs- oder Stoppentscheidung. Für belastbare Betriebseffekte kann ein längerer Zeitraum nötig sein. Kein offenes Ende.
Wenn alle sieben Antworten vorliegen, kann der Pilot starten. Wenn eine wesentliche Voraussetzung fehlt, kommt zuerst die Vorarbeit.
Drei Fehler, die sich wiederholen
- Tool-Reflex. „Wir haben jetzt Copilot-Lizenzen, also müssen wir Use-Cases finden.“ Die Reihenfolge ist umgekehrt: erst der Use-Case, dann das Tool. Eine Lizenz ohne klares Problem ist oft nur eine teure Suchmaschine.
- Workshop-Reflex. Ideen ohne Arbeitsbezug. Beobachtung und strukturierte Ideenarbeit gehören zusammen; jeder Vorschlag muss ein konkretes Problem und einen prüfbaren Nutzen benennen.
- Leuchtturm-Reflex. Der schwierigste Use-Case kommt zuerst, weil er am spannendsten klingt. Das Ergebnis ist oft ein Projekt, das zwei Jahre braucht, zwischendurch niemand wirklich betreibt und nach dem Scheitern die Organisation vorsichtiger macht als zuvor. Kleine produktive Fälle sind weniger spektakulär, aber sie zeigen, wie eine Organisation mit KI arbeitet.
Warum dieses Bild
Zwei Quellen stützen die Bedeutung der Arbeitsorganisation. McKinsey State of AI 2025 berichtet einen Zusammenhang zwischen Workflow-Neugestaltung und EBIT-Wirkung; die Befragung belegt keine alleinige Ursache. BCGs 10–20–70-Regel von 2025 beschreibt die Verteilung des Aufwands: zehn Prozent für Algorithmen, zwanzig für Technologie und Daten, siebzig für Menschen und Prozesse. Das ist eine Orientierungsregel, kein gemessener Wertanteil für jedes Unternehmen.
Vier Wochen, vier Blöcke und sieben Prüffragen sind mein Ausgangspunkt für eine begrenzte Kandidatenauswahl. Umfang, Datenzugang und Verfügbarkeit der Fachleute bestimmen den tatsächlichen Aufwand. Entscheidend ist, dass am Ende eine begründete Start-, Vorbereitungs- oder Stoppentscheidung steht.